Anadolu Ajansının (AA) "Yapay Zeka Şirketlerinin Kitap Avı" başlıklı dosya haberi kapsamında, küresel yapay zeka şirketlerinin Avrupa'nın ardından Türkiye'deki kitap arşivlerine yönelik adımları yayıncılar ve sektör temsilcileriyle ele alınıyor.
Nobel Akademik Yayıncılık Genel Yayın Yönetmeni Nevzat Argun, AA muhabirine yaptığı açıklamada, yapay zeka şirketlerinin aracı kurumlar üzerinden geniş kapsamlı akademik veri tabanlarını toplama girişiminde bulunduğunu belirterek, bu sürecin hem yayıncılığı hem de bilimsel bilgi üretimini ciddi biçimde tehdit ettiğini söyledi.
Son dönemde yapay zeka modellerinin eğitilmesi amacıyla Türkçe kaynaklara yönelik ilginin arttığına dikkati çeken Argun, kendilerine de benzer bir talep ulaştığını ifade etti.
BİNLERCE KİTAP İÇİN TEK TEK SİPARİŞ VERİLDİ
Argun, Hollanda merkezli bir firma aracılığıyla Nobel Akademik Yayıncılık'a ait 3 binden fazla, diğer yayınevlerine ait ise 2-3 bin olmak üzere binlerce kitabın talep edildiğini aktardı.
Siparişlerin her kitaptan birer adet olacak şekilde verilmesinin şüphe uyandırdığını belirten Argun, yaptıkları değerlendirmeler sonucunda taleplerin yapay zeka eğitimiyle bağlantılı olduğu kanaatine vardıklarını ve tüm siparişleri iptal ettiklerini söyledi.
Argun, "Birer adetlik siparişler olunca durumdan şüphelendik ve rahatsız olduk. Yaptığımız değerlendirmeler sonucunda talebin yapay zeka eğitimiyle bağlantılı olduğu kanaatimiz netleşince tüm siparişleri iptal ettik. Yayın camiasındaki bu tartışmayı başlatan adımlardan birini de biz attık." ifadelerini kullandı.
Sürecin yalnızca basılı kitapların satın alınmasıyla sınırlı olmadığını vurgulayan Argun, yayınevlerinin kitaplarını e-kitap olarak kiralayan dijital platformlara da teklifler götürüldüğünü ve platformlardaki dijital içeriklerin toplu olarak satın alınmasının istendiğini kaydetti.
"TEKELLEŞME VE SÖMÜRGECİ YAKLAŞIM SÖZ KONUSU"
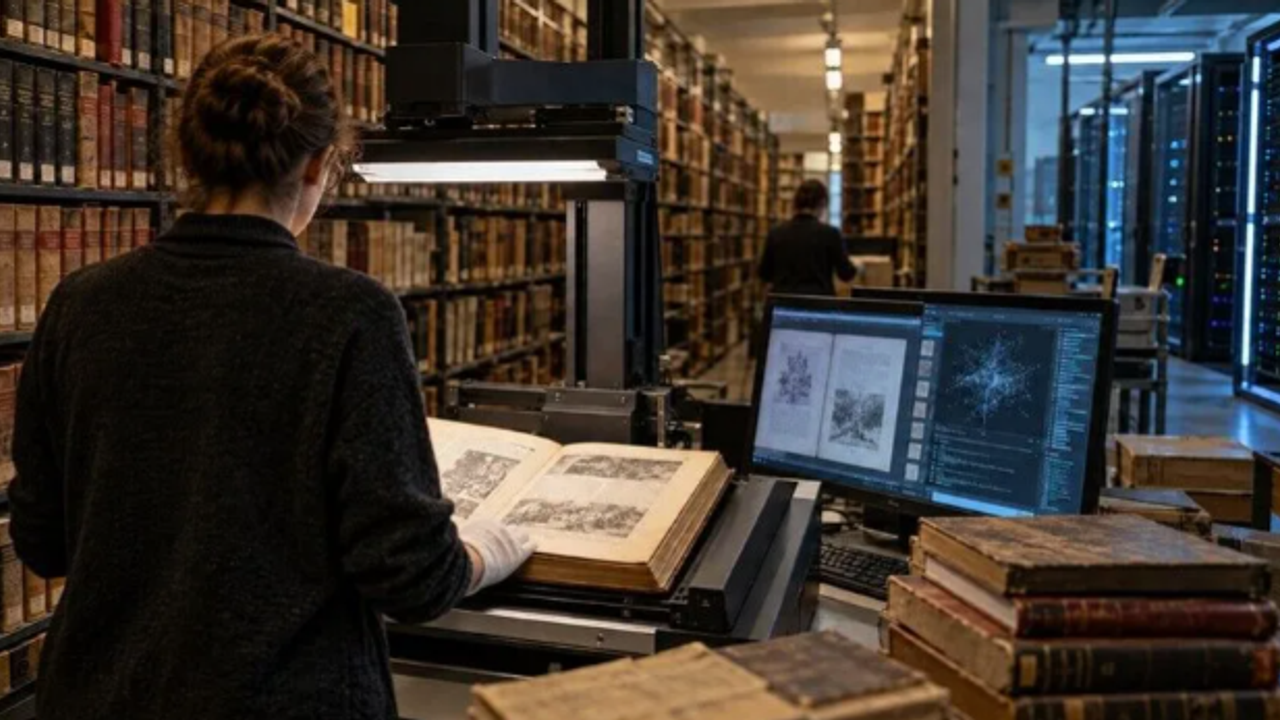
Piyasadaki nadir eserlerin taranarak dijitalleştirildikten sonra fiziksel olarak imha edildiği veya kamuya kapatıldığı yönündeki iddialara da değinen Argun, yaşanan süreci küresel bir tekelleşme hamlesi olarak değerlendirdi.
Aracı şirketlerin hangi ülkeden olduğunun arka plandaki asıl yapıyı değiştirmediğini savunan Argun, Batı merkezli küresel sermayenin akademik yayıncılık alanında tekelleşmeye çalıştığını ileri sürdü.
Argun, "Batı medeniyetinin temelinde hak ettiğinden fazlasını istemek ile görünür hale gelmiş emperyal bir arka plan var. Yayıncılıkta da benzer bir sömürgeci yaklaşımla karşı karşıyayız. Türkiye'deki bir odak eliyle kitapları tek tek toplatıp taratarak kendi sistemlerine yükleyebilirler, bu risk her zaman masada duruyor." dedi.
"AÇIK ERİŞİM DEĞİL, MENŞEİ KAYIP BİR KISIRLAŞMA"
Yapay zeka veri tabanlarına kontrolsüz şekilde aktarılan içeriklerin akademik gelenekleri tahrip ettiğini dile getiren Argun, açık erişim ile yapay zeka modellerine içerik aktarılması arasında önemli fark bulunduğunu söyledi.
Akademik yayıncılığın denetlenebilirlik, hakem süreçleri, atıflar ve kaynakçalar üzerine kurulduğunu belirten Argun, açık erişimde araştırmacıların esere ulaştığını, atıf verdiğini ve yazarın emeğinin görünür olduğunu ifade etti.
Argun, yapay zeka modellerinde ise içeriklerin birbirine karışarak kaynağı, yazarı ve hakem denetimi belirsiz bir bilgi yığınına dönüşebildiğini belirterek, özgün bilginin kaynağının gösterilmemesi ve değerinin korunmamasının akademik üretimi olumsuz etkileyeceğini söyledi.
Kitap satışlarının ciddi ölçüde gerilediği bir dönemde bu sürecin araştırmacıların üretim motivasyonunu da zayıflatabileceğini kaydeden Argun, bunun bilgi üretimini kısırlaştırabileceği uyarısında bulundu.
ÇEVİRİ HAFIZASI DA YAPAY ZEKA ŞİRKETLERİNİN RADARINDA
Küresel şirketlerin yalnızca telifli yerli içeriklerle değil, yayınevlerinin yıllar içinde oluşturduğu çeviri veri tabanlarıyla da ilgilendiğini belirten Argun, yaklaşık üç yıl önce yaşadıkları somut bir girişimi anlattı.
Argun, işbirliği yaptıkları ve kitaplarını Türkçeye çevirdikleri yabancı bir yayınevinin, Türkçeleştirilmiş kitapların verilerini talep ettiğini belirterek, "Türkçeleştirilmiş kitaplarımızın datasını bize verirseniz yapay zekamızı zenginleştirmek istiyoruz, karşılığında bedelini ödeyelim." teklifinin iletildiğini aktardı.
Söz konusu tekliften daha sonra vazgeçildiğini belirten Argun, yabancı yayınevinin kendi portföyündeki kitapları yapay zeka aracılığıyla farklı dillere hızla çevirerek e-kitap olarak erişime açmayı amaçlamış olabileceğini ifade etti.
Argun, "Orijinal metin zaten ellerinde var. İhtiyaç duydukları şey bizim çeviri hafızamızdı." dedi.
"KATKI VERENİN HAK ETTİĞİ PAYI ALDIĞI MODEL ŞART"
Yapay zeka teknolojilerinin kaçınılmaz bir gelişim süreci olduğuna ancak adil bir telif ve paylaşım ekosisteminin kurulması gerektiğine dikkati çeken Argun, mevcut telif sözleşmeleri ve yasal mevzuatın teknolojinin gelişim hızına tam anlamıyla ayak uyduramadığını söyledi.
Gelecekte yerli veya etik bir yapay zeka modeli oluşturulması halinde telif sahiplerinin haklarının korunması gerektiğini vurgulayan Argun, yapay zekanın ürettiği yanıtlarda eserlerden yapılan alıntılar veya kullanım oranlarına göre yayıncı ve yazarlara pay aktarılabileceğini belirtti.
Argun, 100 bin kitaplık bir veri tabanı oluşturulması halinde katkı oranına göre gelir paylaşımı yapılmasının mümkün olduğunu ifade ederek, "Tıpkı dijital video veya arama motoru platformlarının izlenme oranlarına göre içerik üreticisine gelir paylaştırması gibi, ne kadar katkı veriliyorsa o kadar pay alınan adil bir mekanizma hayata geçirilmeli." diye konuştu.